
Konunun öne çıkan noktaları
RAG (Retrieval-Augmented Generation), bir yapay zeka modelinin yanıt üretmeden önce harici bir kaynaktan ilgili bilgileri bulmasını ve bu bilgileri yanıtında kullanmasını sağlayan yaklaşımdır. Böylece model, yalnızca eğitim sırasında öğrendiği bilgilere dayanmak yerine erişebildiği güncel belgelerden, veri tabanlarından veya diğer bilgi kaynaklarından da yararlanabilir.
Bunun SEO açısından önemli bir sonucu var. Web içeriklerinden yararlanan bir sistemde sayfanın tamamı yerine belirli metin parçaları getirilebilir. Bu durumda, sorunun cevabını açık ve anlaşılır biçimde içeren bölümler bilgi erişimini destekleyebilir. Yazının geri kalanı ne kadar kapsamlı olursa olsun, aranan bilgiyi doğru bağlamda sunmayan bir içerik ilgili sorgu için yeterince kullanışlı olmayabilir.
RAG bir bilgi getirme ve yanıt üretme yaklaşımıdır. GEO ve AEO ise içeriklerin yapay zeka destekli yanıt ortamlarında bulunabilirliğini, anlaşılabilirliğini ve kullanılabilirliğini geliştirmeyi hedefleyen optimizasyon yaklaşımlarıdır. Bu süreçte markaların yapay zeka yanıtlarında kaynak olarak gösterilmesi konusu da önem kazanır. AI Citation kavramı, bu kaynak gösterimi ve atıf ilişkisini daha ayrıntılı anlamaya yardımcı olur.
RAG Nedir?
RAG, Türkçeye bilgi getirmeyle güçlendirilmiş üretim olarak çevrilebilecek Retrieval-Augmented Generation ifadesinin kısaltmasıdır. Bu yaklaşım, iki temel işlemi bir araya getirir. Önce bir bilgi getirme bileşeni, kullanıcının sorusuyla ilgili belgeleri veya belge parçalarını bulur. Ardından bir büyük dil modeli (LLM), getirilen içerikleri bağlam olarak kullanarak yanıt oluşturur.
Kavram, Patrick Lewis ve arkadaşlarının 2020 tarihli Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks başlıklı çalışmasıyla literatürde öne çıktı. Temel fikir oldukça basittir. Kitapsız sınava giren bir öğrenciyle kitabı açık giren bir öğrenciyi düşünün. İlk öğrenci soruları mevcut bilgisiyle yanıtlamak zorundadır. İkinci öğrenci ise gerektiğinde ilgili sayfayı bulup bilgiyi kontrol edebilir. RAG yaklaşımı, dil modelinin yanıt üretirken harici kaynaklardan yararlanabilmesini sağlar.
RAG’ın pratikte sunduğu üç temel avantaj vardır.
- Güncel bilgilere erişim. Bilgi kaynakları ve arama indeksleri güncellendiğinde model, yeni içeriklerden yararlanabilir.
- Özel bilgi kaynaklarını kullanma. Şirket içi belgeler, ürün katalogları ve teknik dokümantasyon gibi kaynaklar yanıt üretiminde kullanılabilir.
- Kaynak temelli yanıt üretimi. Yanıtlar, yararlanılan belgelerle ilişkilendirilebilir ve gerektiğinde kaynaklar üzerinden kontrol edilebilir.
Bununla birlikte RAG kullanılması, yanıtların otomatik olarak doğru olacağı veya her yanıtın kaynak göstereceği anlamına gelmez. Sonuçların kalitesi, getirilen bilgilerin doğruluğuna, arama mekanizmasına ve modelin bu bilgileri nasıl kullandığına bağlıdır.
RAG Nasıl Çalışır?
RAG süreci, kullanıcının sorusuyla ilişkili bilgilerin bir kaynaktan getirilmesi ve bu bilgilerin yanıt üretiminde kullanılması üzerine kuruludur. Bu süreç genellikle birkaç saniye içinde tamamlanabilir. Ancak gerçek süre, kullanılan modele, veri kaynağına, arama yöntemine ve ek değerlendirme adımlarına göre değişir.
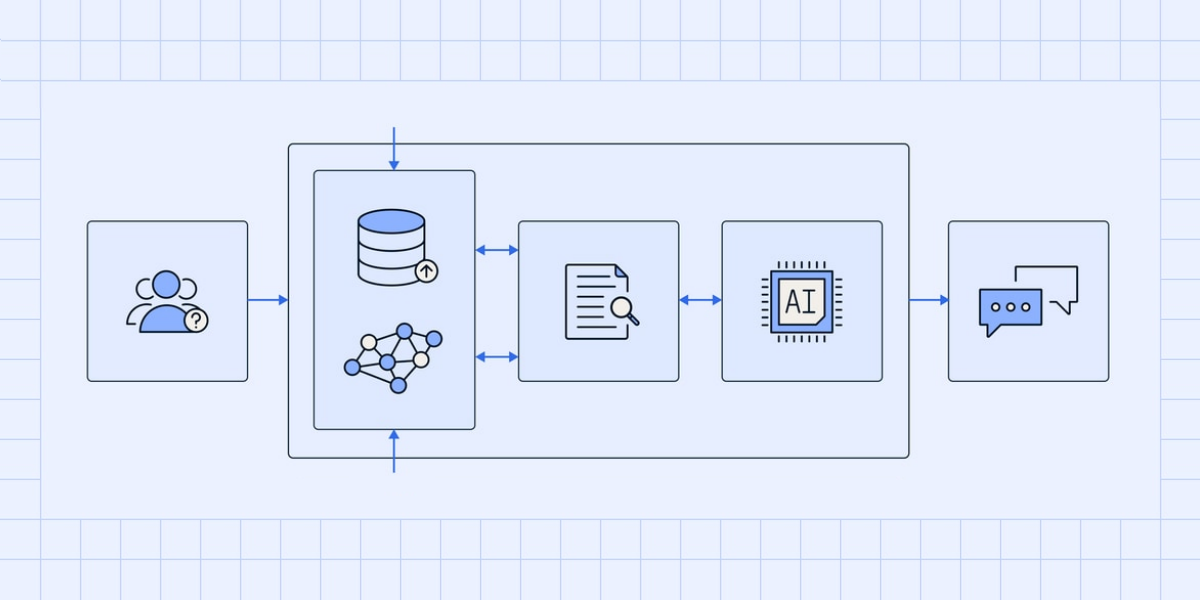
RAG sisteminin sorgulama süreci temel olarak yedi adımdan oluşur.
- Kullanıcı bir soru sorar. Sistem sorguyu işler. Gerektiğinde soruyu yeniden ifade eder veya daha kapsamlı bir arama için alt sorgulara böler.
- Sorgu sayısal bir temsile dönüştürülür. Embedding adı verilen bu temsil, anlamsal arama kullanılan sistemlerde sorgunun anlam özelliklerini sayısal bir vektörle ifade eder.
- Bilgi kaynağında arama yapılır. Sistem, sorguyla ilişkili belgeleri bulmak için vektör veritabanlarını, arama indekslerini veya doküman depolarını kullanabilir.
- İlgili içerik parçaları seçilir. Chunk adı verilen metin parçaları arasından uygun sonuçlar belirlenir. Gerektiğinde reranking uygulanarak sonuçlar yeniden sıralanır.
- Bulunan bilgiler modele aktarılır. Seçilen içerikler, kullanıcının sorusu ve sistem talimatlarıyla birlikte modele bağlam olarak sunulur.
- Yanıt oluşturulur. Dil modeli, getirilen bilgileri kullanarak soruya uygun bir yanıt üretir.
- Yanıt kullanıcıya sunulur. Sistem kaynak göstermeyi destekliyorsa kullanılan belge veya içeriklere ilişkin referansları da yanıta ekleyebilir.
Örneğin, bir e-ticaret destek botuna “İade süresi kaç gün?” diye sorulduğunda sistem, şirketin iade politikası belgesindeki ilgili bölümü bulabilir. Dil modeli de genel bilgisine dayanmak yerine getirilen içeriği temel alarak yanıt oluşturur.
Ancak doğru belgenin bulunması, yanıtın mutlaka doğru olacağı anlamına gelmez. Model belgeyi yanlış yorumlayabilir, önemli bir koşulu gözden kaçırabilir veya kaynakta bulunmayan bir ayrıntı ekleyebilir. Bu nedenle RAG sistemlerinde hem bilgi getirme hem de yanıt üretme aşamalarının değerlendirilmesi gerekir.
RAG’ın çalışma mantığını anlamak için yalnızca sorgulama sürecine bakmak yeterli değildir. Belgelerin önceden nasıl hazırlandığı, hangi yöntemle aranabilir hale getirildiği ve bulunan bilgilerin modele nasıl aktarıldığı da sistemin başarısını etkiler.
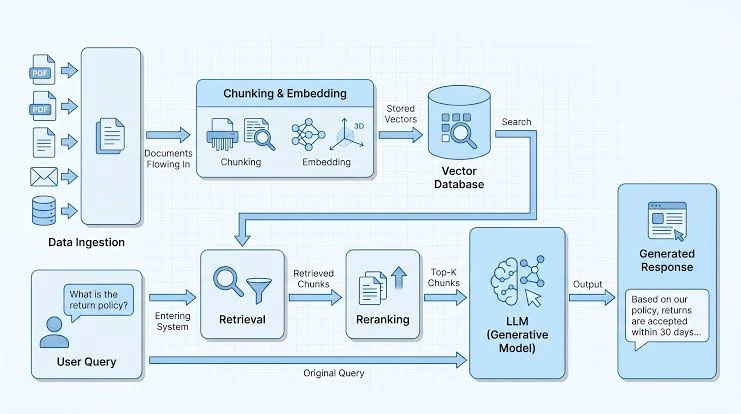
RAG Kullanımı
RAG Mimarisi Hangi Bileşenlerden Oluşur?
Bir RAG sistemi, bilgi kaynaklarından arama mekanizmalarına ve dil modeline kadar birbiriyle bağlantılı bileşenlerden oluşur. Bu bileşenlerin her biri farklı bir görevi üstlenir. Bilginin hazırlanma biçimi, arama yöntemi ve modelin aldığı bağlam birlikte sistemin yanıt kalitesini belirler.
RAG mimarisi iki temel süreç üzerinden düşünülebilir. İlk süreçte belgeler hazırlanır ve aranabilir hale getirilir. İkinci süreçte kullanıcının sorusuna uygun bilgiler bulunarak yanıt üretiminde kullanılır. Her sistem aynı teknik bileşenleri kullanmasa da bu ayrım çalışma mantığını anlamayı kolaylaştırır.
Veri kaynakları ve belge işleme
Veri kaynakları, sistemin bilgi alacağı belgeleri, veri tabanlarını, web sayfalarını veya dokümantasyon havuzlarını kapsar. İlk aşamada içerikler toplanır, temizlenir ve işlenebilir hale getirilir. Yinelenen metinler, hatalı biçimlendirme veya eksik içerikler bilgi erişiminin kalitesini olumsuz etkileyebilir.
Kaynakların güncelliği de önemlidir. Örneğin, bir şirketin eski iade politikası arama indeksinde kalmışsa sistem doğru arama yapsa bile geçerliliğini yitirmiş bilgi getirebilir. Bu nedenle belge işleme süreci, kaynakların düzenli olarak güncellenmesini de kapsamalıdır.
Chunking
Chunking, uzun içeriklerin daha küçük ve anlamlı parçalara bölünmesidir. Bu parçalar, RAG sisteminin arama sırasında getirebileceği metin birimlerini oluşturur. Parçalar gereğinden kısa olduğunda açıklamanın bağlamı kaybolabilir. Çok uzun olduklarında ise soruyla doğrudan ilişkili olmayan bilgiler de modele aktarılabilir. Bu nedenle parçaların boyutu kadar anlamsal bütünlüğü de önemlidir.
Başlıkları ve paragrafları izleyen, ilgili açıklamaları bir arada tutan bir bölümlendirme yöntemi, bilginin doğru bağlamda bulunmasına yardımcı olabilir. Bununla birlikte en uygun parça boyutu, kullanılan arama yöntemi, belge türü ve uygulamanın ihtiyaçlarına göre değişir.
Embedding
Embedding, bir metnin anlamsal özelliklerinin sayısal bir vektörle temsil edilmesidir. Bu temsil, sistemin metinler arasındaki anlamsal benzerliği değerlendirmesine yardımcı olur. Örneğin, “araba” ve “otomobil” kelimeleri farklı yazılsa da benzer anlamlar taşır. Uygun bir embedding modeli, bu anlamsal yakınlığı sayısal temsillere yansıtabilir. Böylece sistem, yalnızca birebir kelime eşleşmesine bağlı kalmadan ilişkili içerikleri bulabilir.
Embedding işlemi, RAG sistemlerinin tamamında zorunlu değildir. Vektör tabanlı anlamsal arama kullanan sistemlerde önemli bir rol oynarken farklı bilgi erişim mimarileri başka yöntemlerden de yararlanabilir.
Vektör veritabanı ve arama sistemleri
Vektör veritabanı, embedding temsillerinin saklanmasını ve benzerlik aramalarının yapılmasını sağlayan bir veri deposudur. Sorgunun vektörü ile içeriklerin vektörleri karşılaştırılarak anlamsal açıdan yakın sonuçlar belirlenebilir. Bunun yanında klasik anahtar kelime araması da RAG sistemlerinde kullanılabilir. Anahtar kelime araması, özellikle ürün kodları, özel isimler ve belirli teknik terimler gibi kesin eşleşmenin önemli olduğu sorgularda yararlı olabilir.
Anlamsal aramayı anahtar kelime aramasıyla birleştiren yaklaşıma hybrid search denir. Örneğin, bir kullanıcı belirli bir ürün kodunu ararken sistemin tam eşleşmeyi bulması gerekir. Aynı kullanıcı ürünün hangi özellikleri desteklediğini doğal dille sorduğunda ise anlamsal arama daha fazla katkı sağlayabilir. RAG kurmak için mutlaka bir vektör veritabanı kullanmak gerekmez. Geleneksel arama indeksleri, farklı veri depoları veya birden fazla arama yöntemini birleştiren sistemler de kullanılabilir.
Retriever ve reranker
Retriever, kullanıcı sorgusuyla ilişkili aday içerikleri bilgi kaynağından getiren bileşendir. Buradaki amaç, yanıt üretiminde kullanılabilecek belgeleri veya metin parçalarını belirlemektir. Reranker ise getirilen adayları sorguyla ilişkilerine göre yeniden değerlendirir ve daha uygun sonuçları üst sıralara taşıyabilir. Böylece ilk arama aşamasında bulunan içerikler arasından daha isabetli bir seçim yapılmasına yardımcı olur.
Retriever ve reranker farklı görevleri yerine getirir. Retriever aday içerikleri bulmaya odaklanırken reranker mevcut adayların sıralamasını iyileştirir. Bununla birlikte her RAG sistemi ayrı bir reranker bileşeni kullanmak zorunda değildir.
LLM ve prompt bağlamı
LLM, getirilen içerikleri ve sistem talimatlarını kullanarak yanıtı oluşturan dil modelidir. Bu aşamada modelin yalnızca soruyu değil, soruyla ilişkili belgeleri de değerlendirmesi beklenir.
Modelin tek seferde işleyebildiği metin miktarına context window denir. Bu sınır, kullanıcı sorusu, sistem talimatları ve getirilen belgelerin birlikte ne kadar bilgi içerebileceğini etkiler. Gereğinden fazla içerik eklemek bağlam kapasitesini tüketebilir ve yanıtın odağını dağıtabilir. Çok az içerik getirmek ise gerekli ayrıntıların eksik kalmasına neden olabilir. Bu nedenle ilgili bilgilerin doğru seçilmesi, RAG mimarisinin önemli bir parçasıdır.
Kaynak izleme ve yanıt değerlendirme
Kaynak izleme, yanıtın hangi belge veya içeriklere dayandığının takip edilmesini sağlar. Sistem uygun şekilde tasarlanmışsa kullanıcı, yanıtın dayandığı kaynakları inceleyebilir.
Yanıt değerlendirme katmanı ise getirilen bilgilerin soruyla ne kadar ilişkili olduğunu ve üretilen yanıtın bu bilgilerle desteklenip desteklenmediğini kontrol etmeye yardımcı olur. Bu kontroller, hatalı veya yetersiz yanıtların tespit edilmesini kolaylaştırabilir. Ancak kaynakların doğru gösterilmesi bile yanıttaki her iddianın doğru olduğunu tek başına kanıtlamaz. Kaynak ile yanıt arasındaki ilişkinin ayrıca değerlendirilmesi gerekir.
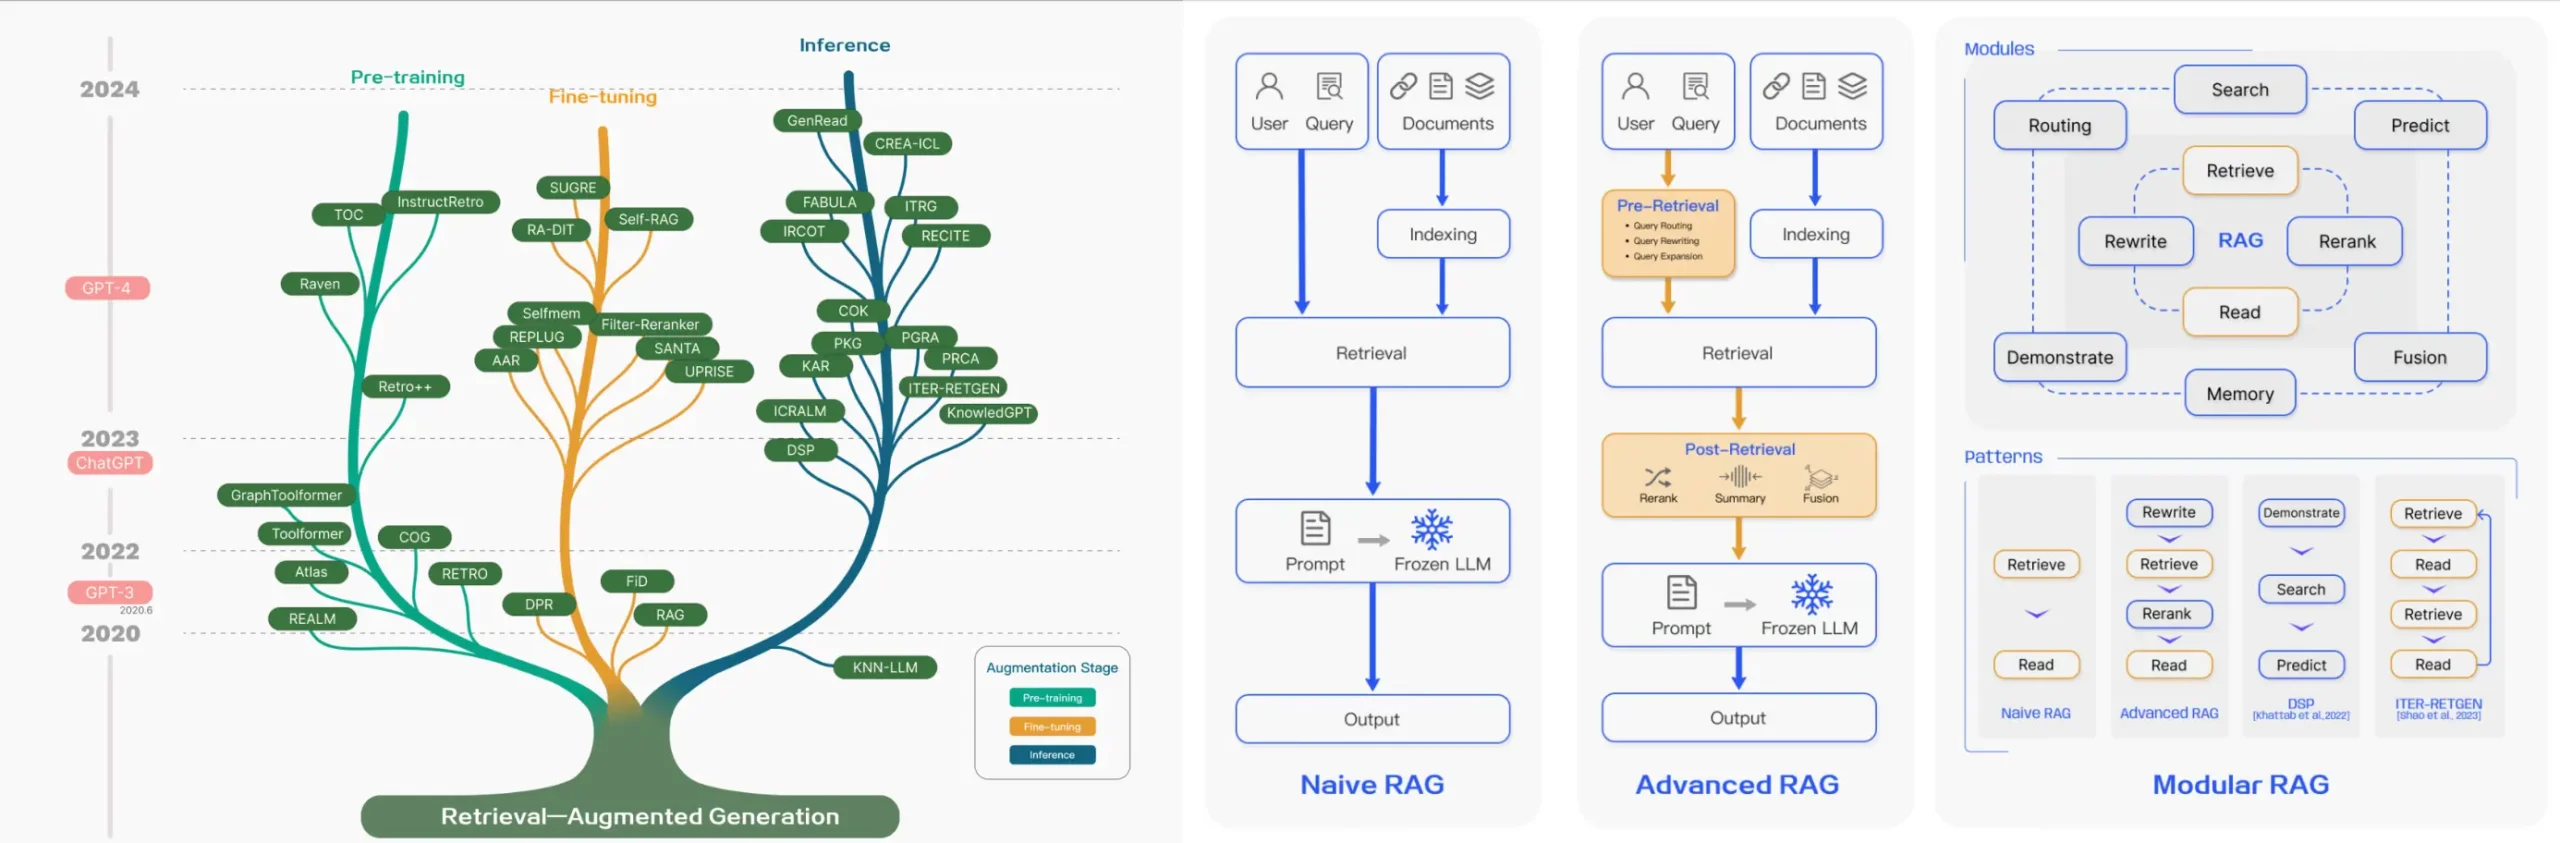
RAG Mimarisi
RAG ile Geleneksel LLM Yaklaşımı Arasındaki Fark
Geleneksel bir LLM, yanıtlarını eğitim sürecinde öğrendiği örüntülere ve bilgilere dayanarak üretir. RAG kullanan bir sistem ise yanıt oluşturmadan önce harici kaynaklardan getirilen bilgileri de kullanır.
Aradaki farkı, hafızasındaki bilgilere dayanarak konuşan bir uzman ile yanıt vermeden önce ilgili belgeleri inceleyen bir uzman arasındaki farka benzetebiliriz.
Bu yaklaşım özellikle iki durumda önem kazanır. İlki güncelliktir. Bir modelin eğitim verileri, daha sonra yaşanan gelişmeleri kapsamayabilir. RAG, uygun ve güncel kaynaklara erişebildiği sürece modelin bu bilgilerden yararlanmasını sağlayabilir.
İkinci durum, kuruma özel verilerdir. Şirket içi yönergeler, ürün katalogları, müşteri sözleşmeleri ve teknik dokümantasyon gibi kaynaklar, modelin yeniden eğitilmesine gerek kalmadan yanıt üretiminde kullanılabilir.
Ancak LLM ile RAG, birbirinin alternatifi olan iki ayrı teknoloji değildir. LLM metin üreten dil modelini ifade ederken RAG, harici kaynaklardan bilgi getirme ve bu bilgileri yanıt üretiminde kullanma yaklaşımıdır. Dolayısıyla RAG, bir dil modeliyle birlikte çalışabilir.
Bazı yapay zeka sistemleri web araması, belge erişimi veya kurumsal bilgi tabanları üzerinden benzer mekanizmalardan yararlanırken bazıları yalnızca modelin mevcut yetenekleriyle yanıt üretir.
Bir sistemin harici kaynaklara erişmesi, tek başına belirli bir RAG mimarisi kullandığını kanıtlamaz. Benzer şekilde, yalnızca yanıt metnine bakarak belirli bir cevabın RAG ile üretilip üretilmediğini anlamak da her zaman mümkün değildir. Bu nedenle teknik değerlendirmelerde doğrulanabilir mimari bilgileriyle sistemin davranışından çıkarılan olasılıkları birbirinden ayırmak gerekir.
RAG ile Fine-Tuning Arasındaki Farklar
RAG, yanıt üretimi sırasında harici kaynaklardan bilgi getirirken fine-tuning, modelin belirli görevlerdeki performansını veya davranışını ek eğitimle geliştirmeyi amaçlar. İki yaklaşım farklı ihtiyaçlara odaklanır.
RAG, modelin ihtiyaç duyduğu bilgiye erişmesini sağlar. Fine-tuning ise modelin belirli bir görevi nasıl yerine getireceğini, hangi çıktı biçimini kullanacağını veya belirli örüntülere nasıl yanıt vereceğini öğrenmesine yardımcı olabilir.
| Kriter | RAG | Fine-tuning |
| Temel amaç | Harici bilgileri yanıt üretiminde kullanmak | Modeli belirli görevlere ve davranış kalıplarına uyarlamak |
| Bilgi güncelleme | Bilgi kaynakları ve arama indeksi güncellenebilir | Yeni bilgilerin öğrenilmesi için ek eğitim gerekebilir |
| Harici veri erişimi | Bilgiyi getirme mekanizması içerir | Tek başına harici kaynaklara erişim sağlamaz |
| Kaynak gösterme | Getirilen içeriklere dayalı kaynak gösterimi yapılabilir | Tek başına kaynak gösterimi sağlamaz |
| Model ağırlıkları | Genellikle değiştirilmez | Eğitim sırasında güncellenir |
| Birlikte kullanım | Fine-tuning ile birlikte kullanılabilir | RAG ile birlikte kullanılabilir |
Hangi yaklaşımın tercih edileceği, çözülmek istenen probleme bağlıdır. Sık güncellenen ürün dokümantasyonu, şirket politikaları veya teknik bilgiler söz konusu olduğunda RAG daha pratik bir seçenek olabilir. Çünkü bilgiyi güncellemek için çoğu durumda modelin yeniden eğitilmesi gerekmez.
Belirli bir yazım üslubunu benimsetmek, sınıflandırma performansını geliştirmek veya tutarlı bir çıktı formatı oluşturmak hedefleniyorsa fine-tuning daha uygun olabilir.
Bu iki yaklaşım birbirinin alternatifi olmak zorunda değildir. Bir sistemde fine-tuning ile modelin görev davranışı iyileştirilirken RAG aracılığıyla güncel ve kuruma özel bilgilere erişim sağlanabilir. Böylece modelin hem belirli bir göreve uyum sağlaması hem de yanıtlarını ilgili kaynaklarla desteklemesi mümkün olur.
RAG Nerelerde Kullanılır?
RAG, yanıt kalitesinin güncel, doğru ve belirli bir kaynaktan alınan bilgilere bağlı olduğu birçok alanda kullanılabilir. Kurum içi bilgi asistanlarından müşteri destek sistemlerine kadar farklı uygulamalarda, ilgili verilerin bulunmasını ve bu verilerin yanıt üretiminde kullanılmasını sağlar.
| Kullanım alanı | Getirilen veri | Örnek soru |
| Kurum içi bilgi asistanı | İç yönergeler, süreç dokümanları ve toplantı notları | “Yıllık izin talebi kimin onayına gider?” |
| Müşteri destek sistemi | İade politikaları, sıkça sorulan sorular ve ürün kılavuzları | “İade edilen ürünün kargo ücreti geri ödenir mi?” |
| Doküman ve araştırma asistanı | PDF dosyaları, akademik makaleler ve raporlar | “Bu raporun sonuç bölümünde hangi bulgular yer alıyor?” |
| E-ticaret ürün danışmanı | Ürün katalogları, teknik özellikler ve stok verileri | “Bu telefon kablosuz şarjı destekliyor mu?” |
| Teknik destek ve geliştirici dokümantasyonu | Teknik dokümantasyon, API referansları ve sürüm notları | “Bu API’de sayfalama nasıl yapılır?” |
| Yapay zeka destekli arama sistemleri | Web sayfaları, arama indeksleri ve ilgili içerik parçaları | “RAG ile fine-tuning arasındaki fark nedir?” |
Bu kullanım alanlarının ortak noktası, modelin yalnızca genel bilgisine dayanmak yerine soruyla ilişkili kaynaklardan yararlanmasıdır. Ancak RAG kullanılması, yanıtın doğruluğunu tek başına garanti etmez. Sonuçlar bilgi kaynağının kalitesine, içeriklerin güncelliğine ve arama mekanizmasının doğru parçaları bulabilmesine bağlıdır.
Örneğin, müşteri destek sisteminde güncelliğini yitirmiş bir iade politikası bulunuyorsa model bu belgeyi temel alarak yanlış bilgi verebilir. Bu nedenle RAG uygulamalarında yalnızca yanıt üretimine değil, veri kaynaklarının güncellenmesine, arama sonuçlarının kalitesine ve yanıtların kaynaklarla tutarlılığının değerlendirilmesine de önem verilmelidir.
RAG’ın Avantajları ve Sınırlılıkları
RAG’ın en önemli avantajı, dil modelini yeniden eğitmeden harici bilgi kaynaklarından yararlanmayı mümkün kılmasıdır. Bununla birlikte doğru kaynaklara erişmek, üretilen yanıtların her zaman doğru olacağını garanti etmez. Sistemin performansı, getirilen bilgilerin kalitesine ve modelin bu bilgileri nasıl kullandığına bağlıdır.
RAG’ın Avantajları
- Güncel bilgiye erişim sağlar. Bilgi kaynakları ve arama indeksleri güncellenerek modelin yeni içeriklerden yararlanması sağlanabilir.
- Kaynak gösterimini destekler. Yanıtlar kullanılan belge veya içeriklerle ilişkilendirilebilir. Böylece bilgilerin kontrol edilmesi kolaylaşır.
- Kuruma özel bilgilerin kullanılmasını sağlar. Şirket içi dokümanlar ve özel bilgi tabanları, modelin yeniden eğitilmesine gerek kalmadan yanıt üretiminde kullanılabilir.
- Bilgi güncellemelerini kolaylaştırır. İçerik değiştiğinde çoğu durumda modeli yeniden eğitmek yerine ilgili kaynakları ve arama indeksini güncellemek yeterlidir.
RAG’ın Sınırlılıkları
RAG sistemlerinde bilgi getirme süreci, yeni hata olasılıklarını da beraberinde getirir. Sistem soruyla yeterince ilişkili olmayan bir belgeyi seçebilir veya önemli bir ayrıntıyı içeren metin parçasını bulamayabilir. İçeriğin hatalı bölümlere ayrılması da gerekli bağlamın kaybolmasına neden olabilir.
Bir diğer sınırlılık yanıt süresidir. Bilgi arama, sonuçları yeniden sıralama ve ek doğrulama adımları, doğrudan yanıt üreten sistemlere kıyasla gecikmeyi artırabilir. Bu durum özellikle yanıt süresinin kritik olduğu uygulamalarda dikkate alınmalıdır.
Erişim izinleri de dikkatle yönetilmelidir. Kullanıcının görme yetkisi olmayan bir belgenin arama sonuçlarına dahil edilmesi, hassas bilgilerin açığa çıkmasına yol açabilir. Bu nedenle yetkilendirme kontrollerinin yalnızca yanıt oluşturma aşamasında değil, bilgi getirme sürecinde de uygulanması gerekir.
RAG Sisteminin Kalite Kontrolü
Bir RAG sisteminin başarısı yalnızca doğru yanıt üretmesiyle ölçülmez. Yanıtın hangi kaynaklardan beslendiği, getirilen bilgilerin soruyla ne kadar ilişkili olduğu ve kaynakların güncelliği de değerlendirilmelidir.
Aşağıdaki altı kontrol alanı, olası sorunların bilgi getirme sürecinden mi yoksa yanıt üretiminden mi kaynaklandığını anlamaya yardımcı olur.
| Kontrol alanı | Sorulması gereken soru |
| Retrieval | Sistem doğru belgeleri bulabiliyor mu? |
| Relevance | Getirilen metin parçaları kullanıcının sorusuyla ilgili mi? |
| Grounding | Üretilen yanıt, kaynaklardaki bilgilerle destekleniyor mu? |
| Citation | Gösterilen kaynaklar, yanıtın ilgili iddialarını gerçekten destekliyor mu? |
| Freshness | Kullanılan bilgiler güncel ve geçerli mi? |
| Access control | Sistem yalnızca kullanıcının erişim yetkisi bulunan bilgileri mi getiriyor? |
Bu alanlar, sistemdeki sorunların kaynağını belirlemek için birlikte değerlendirilmelidir.
Örneğin, doğru belge bulunamıyorsa retrieval mekanizması incelenmelidir. İlgisiz içerikler getiriliyorsa arama ve sıralama yöntemleri gözden geçirilmelidir. Yanıt kaynakla çelişiyorsa grounding değerlendirmesi, kaynak doğru olsa bile eski bilgiler kullanılıyorsa freshness kontrolü öne çıkar. Kaynakların yanıtı gerçekten destekleyip desteklemediği ise citation değerlendirmesinin konusudur.
Bu kontroller gerektiğinde uygun metrikler ve test senaryolarıyla desteklenebilir. Örneğin, doğru belgelerin ilk sıralarda bulunması bilgi getirme performansını değerlendirmek için, yanıtların kaynaklarla tutarlılığı ise üretim kalitesini incelemek için kullanılabilir. Ancak her sistem için aynı metriklerin veya eşik değerlerinin uygun olduğu varsayılmamalıdır.
Düzenli kalite kontrolü, RAG sisteminin yalnızca yanıt üretmesini değil, güvenilir, güncel ve erişim kurallarına uygun yanıtlar sunmasını da destekler.
RAG, GEO ve AI Search İlişkisi
RAG, yapay zeka destekli arama sistemlerini anlamak açısından önemlidir. Ancak her yapay zeka arama deneyiminin aynı RAG mimarisini kullandığını varsaymak doğru olmaz. Sistemler farklı arama, bilgi getirme ve yanıt üretme yöntemlerini bir arada kullanabilir.
GEO (Generative Engine Optimization), markaların ve içeriklerin yapay zeka destekli yanıt sistemlerinde daha görünür, anlaşılır ve kullanılabilir olmasını hedefleyen optimizasyon yaklaşımıdır. RAG ise bilgi getirme ve yanıt üretme sürecini bir araya getiren teknik bir mimaridir. İki kavram birbiriyle ilişkili olsa da aynı şeyi ifade etmez.
SEO, GEO ve AEO açısından temel soru, içeriğin yalnızca yayımlanmış olması değil, kullanıcıların bilgi ihtiyacını ne kadar iyi karşıladığıdır. Açık bir yapıya sahip olan, sorulara doğrudan yanıt veren, güvenilir kaynaklarla desteklenen ve kavramlar arasındaki ilişkileri net biçimde açıklayan içerikler hem kullanıcılar hem de bilgi erişim sistemleri açısından yararlı olabilir.
RAG Sistemleri İçin İçerik Optimizasyonu
RAG sistemlerinin kullandığı getirim yöntemleri farklılaşsa da içerik kalitesini geliştirmek için uygulanabilecek bazı temel ilkeler vardır.
- Soruyu doğrudan yanıtla. Temel tanımı veya önemli bilgiyi uzun bir girişin arkasına gizleme. Kullanıcının aradığı cevabı açık biçimde sun. İçeriğin temel sonucunu başta verme yaklaşımını ele alan BLUF, BUFF ve TUFF ile içerik yazımı rehberine de göz atabilirsin.
- Anlamlı içerik parçaları oluştur. Başlık, paragraf ve liste yapısını mantıksal bütünlüğe göre düzenle. Birbirini tamamlayan bilgileri mümkün olduğunca aynı bağlamda tut.
- Kavramları açıkça tanımla. Kısaltmaları ilk kullanımda açıkla ve birbiriyle karıştırılabilecek kavramlar arasındaki farkları belirt.
- İddiaları güvenilir kaynaklarla destekle. Özellikle teknik açıklamalarda kaynak bağlantıları ver ve okuyucunun iddiaları kontrol edebilmesini sağla.
- Bilginin güncelliğini koru. Teknik dokümantasyon, ürün özellikleri ve zamanla değişen bilgiler için güncelleme süreci oluştur.
- Teknik erişilebilirliği kontrol et. İçeriğin taranabilir, erişilebilir ve uygun biçimde sunulabilir olduğundan emin ol.
Bu ilkeler, bir içeriğin RAG sistemlerinde mutlaka getirileceğini veya yapay zeka yanıtlarında kaynak gösterileceğini garanti etmez. Bunun nedeni, içerik kalitesinin yanında arama sisteminin mimarisinin, kaynak havuzunun, sıralama yöntemlerinin ve sorgunun da sonucu etkilemesidir.
SEO açısından çıkarılabilecek önemli sonuç, içerik üretiminin yalnızca belirli anahtar kelimelerde sıralama kazanmayı hedeflememesi gerektiğidir. Bilginin doğru, anlaşılır, güncel ve kaynaklarla desteklenmiş olması da uzun vadeli içerik kalitesinin bir parçasıdır.
RAG Hakkında Sıkça Sorulan Sorular
RAG sistemlerinde chunking neden önemlidir?
Chunking, belgelerin bilgi getirme sırasında daha kolay eşleştirilebilen küçük metin parçalarına bölünmesini sağlar. Parçalar çok büyük olduğunda ilgili bilgi ayırt edilemeyebilir, çok küçük olduğunda ise bağlam kaybolabilir. Bu nedenle parça boyutu ve örtüşme oranı, içeriğin yapısına ve arama senaryosuna göre belirlenmelidir.
Web içerikleri RAG sistemleri için nasıl optimize edilir?
Web içerikleri, açık başlıklar, net tanımlar, tutarlı kavram kullanımı ve doğrulanabilir bilgilerle düzenlendiğinde bilgi erişimini destekleyebilir. Sayfanın taranabilir olması ve içeriğe teknik olarak erişilebilmesi de önemlidir. Ancak bu düzenlemeler, belirli bir RAG sisteminin sayfayı getireceğini veya yapay zeka yanıtında kaynak göstereceğini garanti etmez.
RAG sistemlerinde vektör veritabanı kullanmak zorunlu mudur?
Hayır, RAG sistemlerinde vektör veritabanı kullanmak zorunlu değildir. Bilgi getirme işlemi anahtar kelime araması, vektör araması veya hibrit arama yöntemleriyle gerçekleştirilebilir. Uygun yöntem, verinin yapısına, sorguların türüne ve sistemin ihtiyaçlarına bağlıdır. Bazı mimarilerde vektör veritabanı yerine farklı arama altyapıları kullanılabilir.
RAG sistemleri yanlış veya güncelliğini yitirmiş yanıtlar üretebilir mi?
Evet, RAG sistemleri yanlış, eksik veya güncelliğini yitirmiş bilgiler içeren yanıtlar üretebilir. Bunun nedeni kaynak verilerin hatalı olması, ilgili belgelerin getirilememesi veya dil modelinin sağlanan bağlamı yanlış yorumlaması olabilir. Bu nedenle kaynak kalitesi, bilgi getirme başarısı ve yanıt doğruluğu ayrı ayrı değerlendirilmelidir.
RAG sistemleri için SEO çalışmaları neden önemlidir?
SEO çalışmaları, web içeriklerinin taranabilirliğini, erişilebilirliğini ve anlaşılabilirliğini destekleyerek RAG tabanlı sistemlerin bilgiye erişim sürecine katkı sağlayabilir. Açık başlıklar, tutarlı içerik yapısı, doğru teknik yapılandırma ve güvenilir bilgiler, ilgili içeriğin bulunmasını kolaylaştırabilir. Ancak SEO uyumlu olmak, bir içeriğin RAG sistemleri tarafından kullanılacağını veya kaynak gösterileceğini garanti etmez.
RAG, büyük dil modellerinin yanıt üretimini harici bilgi kaynaklarına erişimle birleştiren önemli bir yaklaşımdır. Güncel belgelerden yararlanmayı, kurumsal bilgiye erişimi ve kaynak temelli yanıtlar oluşturmayı kolaylaştırabilir. Bununla birlikte sonuçların kalitesi, yalnızca dil modelinin gücüne değil, getirilen bilgilerin doğruluğuna, arama yöntemine ve modelin bu bilgileri nasıl kullandığına da bağlıdır.
SEO, GEO ve AI Search alanlarında çalışanlar için RAG’i anlamak, içeriklerin yapay zeka destekli bilgi erişiminde nasıl kullanılabileceğini değerlendirmek açısından yararlı bir başlangıç noktasıdır. İçerikleri açık, tutarlı, güncel ve güvenilir kaynaklarla desteklenmiş biçimde hazırlamak, hem kullanıcı deneyimini hem de bilgi erişiminin kalitesini destekleyebilir.
Kaynaklar
- Lewis ve diğerleri, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Microsoft Learn, Retrieval-Augmented Generation (RAG) in Azure AI Search